SCI Webhosting

  • El costo oculto de un VPS barato: ¿cuánto perdería tu empresa si mañana deja de funcionar?

    El costo oculto de un VPS barato: ¿cuánto perdería tu empresa si mañana deja de funcionar?

    Un servidor virtual de bajo costo puede parecer una excelente decisión financiera. Sin embargo, cuando de él dependen las ventas, la facturación o las operaciones de una empresa, el verdadero costo no siempre aparece en la factura mensual.

    Hace algunos años, muchas pequeñas y medianas empresas comenzaron a trasladar sus aplicaciones a servidores virtuales privados, conocidos como VPS. La posibilidad de disponer de un servidor propio sin invertir en equipos físicos convirtió esta tecnología en una alternativa atractiva para alojar páginas web, sistemas administrativos, bases de datos y aplicaciones empresariales.

    Actualmente es posible contratar servidores virtuales a precios muy competitivos. Para una empresa que busca controlar sus gastos, la propuesta resulta difícil de ignorar: recursos disponibles en pocos minutos, costos mensuales predecibles y libertad para instalar prácticamente cualquier aplicación.

    El problema aparece cuando el crecimiento del negocio transforma ese servidor económico en una pieza indispensable de la operación, sin que necesariamente cambien las condiciones bajo las cuales fue contratado.

    Un servicio pensado inicialmente para alojar una aplicación pequeña puede terminar soportando el sistema de facturación, el inventario, la gestión de clientes y buena parte de las operaciones diarias de una organización.

    Y cuando eso sucede, el precio del servidor deja de ser el único factor importante.

    El día que un VPS deja de ser simplemente un servidor

    Imaginemos una empresa distribuidora que utiliza un sistema de gestión alojado en un VPS. Cada mañana, sus colaboradores ingresan para revisar pedidos, registrar movimientos de inventario y emitir documentos comerciales. La empresa ha desarrollado una dependencia importante de esa plataforma, aunque rara vez se detiene a pensar en la infraestructura que la mantiene funcionando.

    Todo parece estar bajo control hasta que un día el sistema deja de responder.

    Los trabajadores intentan ingresar sin éxito. El área comercial no puede consultar la información de los clientes, el almacén tiene dificultades para preparar pedidos y la facturación empieza a acumular retrasos. Mientras tanto, alguien debe contactar al proveedor y averiguar qué ha sucedido.

    Si el problema se resuelve en pocos minutos, probablemente no pase de una molestia. Pero si la interrupción se prolonga durante varias horas, las consecuencias pueden comenzar a afectar directamente a los clientes y los ingresos del negocio.

    En ese momento, una empresa descubre que el costo de su infraestructura no equivale únicamente al importe que paga cada mes.

    El verdadero costo incluye lo que puede perder cuando sus sistemas dejan de estar disponibles.

    El ahorro mensual puede ocultar riesgos importantes

    Un VPS económico no es necesariamente un mal servicio. Existen proveedores confiables y plataformas bien administradas que ofrecen servidores virtuales a precios accesibles. La dificultad aparece cuando la empresa supone que el pago mensual incluye protecciones y responsabilidades que, en realidad, nunca fueron contratadas.

    En muchos servicios básicos, el proveedor se encarga de mantener funcionando el hardware y la plataforma de virtualización, mientras que el cliente debe administrar el sistema operativo, instalar actualizaciones, configurar la seguridad y proteger la información de sus aplicaciones.

    Es una distribución de responsabilidades perfectamente válida cuando existe personal preparado para asumirlas.

    Sin embargo, no todas las pequeñas empresas cuentan con un especialista dedicado a supervisar permanentemente sus servidores. En ocasiones, la infraestructura queda en manos del desarrollador que instaló la aplicación, de un proveedor externo que interviene ocasionalmente o de alguien del equipo que tiene otras responsabilidades.

    Mientras el sistema funciona, esta situación puede pasar inadvertida. Los problemas suelen aparecer durante una falla importante, cuando nadie tiene claro quién debe intervenir, qué procedimientos seguir o cuánto tiempo tomará recuperar la operación.

    Así, el supuesto ahorro de contratar únicamente recursos de cómputo puede convertirse en un gasto operativo mucho mayor si la empresa necesita resolver una emergencia sin preparación previa.

    Las vulnerabilidades también afectan a la infraestructura que no vemos

    Existe otro factor que merece atención: la seguridad del entorno donde funcionan los servidores virtuales.

    Las empresas suelen preocuparse por proteger sus aplicaciones mediante contraseñas, antivirus, firewalls y mecanismos de autenticación. Todas estas medidas son importantes, pero representan solamente una parte de la seguridad.

    Detrás de un VPS existe una plataforma que también debe mantenerse protegida. Su sistema operativo, componentes de red y tecnología de virtualización pueden presentar vulnerabilidades que requieran actualizaciones urgentes.

    Un ejemplo reciente es PwnEscape (CVE-2026-99999), una vulnerabilidad crítica del kernel de Linux divulgada en octubre de 2026. La investigación demostró que, bajo determinadas condiciones, un atacante con control sobre un entorno virtual podía aprovechar un fallo para acceder a información de la memoria del servidor anfitrión. En pruebas de laboratorio también se consiguió ejecutar código con privilegios elevados fuera de la máquina virtual.

    El caso no significa que todos los VPS sean vulnerables ni que compartir infraestructura sea necesariamente inseguro. Lo que demuestra es que incluso las tecnologías de aislamiento utilizadas por plataformas avanzadas necesitan supervisión, mantenimiento y actualizaciones constantes.

    Para una empresa que tiene su sistema principal alojado en un VPS, la enseñanza es importante: proteger su aplicación no basta si desconoce cómo se protege el entorno que la ejecuta.

    Una copia de seguridad no garantiza que puedas seguir trabajando

    Cuando se pregunta a una empresa qué sucedería si pierde su servidor, una respuesta frecuente es que dispone de copias de seguridad.

    Eso es positivo, pero no resuelve completamente el problema.

    Un respaldo permite conservar información que podría ser necesaria durante una recuperación. Sin embargo, para volver a operar también puede ser necesario reconstruir servidores, restaurar bases de datos, configurar aplicaciones, comprobar su funcionamiento y permitir nuevamente el acceso a los usuarios.

    Una empresa puede disponer de una copia reciente de su información y, aun así, necesitar muchas horas para poner en funcionamiento sus sistemas.

    Por esa razón, el respaldo debe formar parte de una estrategia más amplia de continuidad operativa. Es importante determinar qué información se puede perder sin afectar gravemente al negocio, cuánto tiempo puede permanecer inactiva una aplicación y cuáles son los pasos necesarios para recuperarla.

    Estas preguntas tienen una dimensión financiera, no solamente tecnológica.

    Si una plataforma genera o permite procesar una parte importante de los ingresos de una empresa, unas horas de indisponibilidad pueden representar un costo superior al ahorro acumulado durante meses de alojamiento económico.

    ¿Cuándo un VPS empieza a quedarse corto para tu empresa?

    No existe un número universal de usuarios, ventas o transacciones que determine cuándo una empresa debe abandonar un VPS. La decisión depende principalmente de la importancia que tienen las aplicaciones alojadas, de los riesgos que la organización está dispuesta a asumir y de su capacidad para administrarlos.

    Una empresa puede utilizar un VPS sin inconvenientes durante muchos años si dispone de soporte adecuado, respaldos verificados, controles de seguridad y un plan de recuperación razonable.

    Pero la situación cambia cuando el servidor se convierte en el punto central de operaciones que no pueden detenerse. Un ERP utilizado por todas las áreas, una plataforma de reservas, una aplicación logística o un sistema comercial conectado con múltiples sucursales pueden necesitar una infraestructura y un nivel de administración más exigentes.

    También importa la capacidad de crecimiento. A medida que aumenta el número de usuarios y procesos, pueden surgir necesidades de aislamiento, almacenamiento, disponibilidad, monitoreo y recuperación que exceden las condiciones de un servicio básico.

    El punto de inflexión no ocurre necesariamente cuando el VPS se queda sin memoria o capacidad de procesamiento. Ocurre cuando las exigencias del negocio superan las garantías y responsabilidades del servicio contratado.

    Ese es el momento de evaluar alternativas más completas.

    La nube privada administrada como una decisión de continuidad

    Una nube privada administrada ofrece la posibilidad de diseñar la infraestructura considerando las características de cada empresa y las necesidades de sus aplicaciones.

    En lugar de comenzar preguntando cuánta memoria necesita un servidor, el análisis puede partir de preguntas más relevantes: qué sistemas utiliza la organización, cuánto tiempo puede tolerar una interrupción, qué información necesita proteger y quién debe intervenir cuando ocurre un incidente.

    A partir de ese diagnóstico es posible definir una arquitectura con medidas de seguridad, procedimientos de mantenimiento, respaldos y mecanismos de recuperación adaptados a la operación.

    La administración especializada también permite establecer responsabilidades claras. La empresa no necesita convertirse en experta en virtualización para comprender qué nivel de servicio está contratando, quién se ocupa de las actualizaciones y cómo se atienden las situaciones críticas.

    Esto no significa que una nube privada elimine todos los riesgos. Ninguna infraestructura puede garantizar seguridad absoluta o disponibilidad permanente. La ventaja de un servicio bien diseñado y administrado está en reducir los riesgos previsibles y preparar respuestas antes de que las fallas se conviertan en emergencias.

    Para una empresa cuyo negocio depende de sus sistemas informáticos, esa previsión puede resultar mucho más valiosa que una pequeña diferencia en la tarifa mensual.

    Antes de renovar tu VPS, calcula lo que realmente está en juego

    Una manera sencilla de evaluar la infraestructura actual consiste en imaginar qué ocurriría si la aplicación principal de la empresa permaneciera fuera de servicio durante una jornada laboral.

    ¿Cuántos empleados dejarían de trabajar con normalidad? ¿Qué procesos quedarían detenidos? ¿Cuántas ventas, entregas o documentos se retrasarían? ¿Cuánto tiempo tomaría recuperar el sistema y quién tendría la responsabilidad de hacerlo?

    Las respuestas permiten identificar el impacto económico y operativo de una interrupción. También ayudan a determinar si el servicio contratado es proporcional a la importancia de la aplicación.

    Después conviene revisar con el proveedor las condiciones reales de mantenimiento, seguridad y recuperación. La existencia de un respaldo, por ejemplo, debe acompañarse de información sobre su ubicación, frecuencia, verificación y tiempo estimado de restauración.

    Este ejercicio puede revelar que el VPS actual sigue siendo suficiente o que ha llegado el momento de migrar a un entorno mejor administrado.

    La decisión debe sustentarse en el riesgo real, no en el temor a una falla hipotética.

    El servidor más barato no siempre es el que menos cuesta

    La tecnología debería ayudar a las empresas a crecer, no convertirse en una preocupación permanente para sus propietarios.

    Un VPS económico puede ser una excelente herramienta para comenzar un proyecto, alojar aplicaciones de baja criticidad o desarrollar servicios que todavía no requieren una infraestructura compleja. Su utilidad es indiscutible y sigue teniendo un lugar importante en el mercado.

    Pero cuando una empresa depende de una aplicación para facturar, vender, coordinar sus operaciones o atender a sus clientes, la conversación debe cambiar.

    Ya no se trata únicamente de conseguir un servidor que funcione al menor precio posible. Se trata de disponer de una infraestructura acorde con la importancia del negocio y de contar con un equipo capaz de mantenerla, protegerla y recuperarla cuando sea necesario.

    La pregunta correcta no es cuánto puedes ahorrar contratando un VPS más barato, sino cuánto podría costarle a tu empresa no disponer del servicio y la protección que realmente necesita.

    ¿Tus aplicaciones empresariales necesitan algo más que un VPS?

    Si tu empresa depende de sistemas de facturación, ERP, aplicaciones web o bases de datos alojadas en servidores virtuales, conviene revisar si el entorno actual ofrece la seguridad, continuidad y administración que necesitas.

    Nettix desarrolla soluciones de nube privada administrada para empresas de Perú y México, con un enfoque orientado a la operación de aplicaciones empresariales, la protección de la información y el soporte especializado.

    Evalúa una alternativa para tu infraestructura actual:

    Nettix Perú — Soluciones de nube privada para empresas

    Nettix México — Nube privada y soporte empresarial

    Cuando una aplicación se vuelve indispensable para el negocio, la infraestructura que la sostiene también debería recibir esa importancia.
  • CVE-2026-99999 (PwnEscape): ¿es seguro tu VPS?

    CVE-2026-99999 (PwnEscape): ¿es seguro tu VPS?

    Una reciente vulnerabilidad en Linux ha vuelto a poner sobre la mesa una pregunta que pocas empresas se hacen: ¿qué tan protegidos están realmente los servidores donde funcionan sus aplicaciones más importantes?

    Para muchas empresas, contratar un servidor VPS es una decisión relativamente sencilla. Los precios resultan atractivos, la puesta en marcha es rápida y, mientras todo funcione correctamente, no parece haber motivos para cuestionar la infraestructura. Sobre ese servidor pueden instalarse sistemas de facturación, plataformas de ventas, aplicaciones empresariales o incluso bases de datos que concentran buena parte de la información del negocio.

    Sin embargo, detrás de esa aparente tranquilidad existe una realidad que no siempre se conoce. Los servidores virtuales dependen de una infraestructura física y de componentes de software que deben mantenerse permanentemente actualizados. Cuando aparece una vulnerabilidad importante en esa infraestructura, la seguridad de una aplicación puede verse comprometida por un problema que no se encuentra dentro de ella.

    Ese es precisamente el debate que ha reabierto PwnEscape, identificada como CVE-2026-99999, una vulnerabilidad crítica del kernel de Linux divulgada en octubre de 2026.

    PwnEscape: cuando el problema está fuera de tu servidor

    Para entender la importancia de esta vulnerabilidad, primero debemos recordar cómo funciona un VPS. Aunque el cliente percibe que dispone de un servidor independiente, en muchas plataformas varios servidores virtuales comparten un mismo equipo físico, manteniéndose separados mediante tecnologías de virtualización.

    Esa separación es uno de los fundamentos de la computación en la nube. En condiciones normales, lo que sucede dentro de un servidor virtual no debería permitir acceder al sistema que lo hospeda ni afectar a otros clientes.

    La investigación de PwnEscape demostró que determinadas condiciones en el procesamiento de paquetes de red de Linux podían romper esa frontera de seguridad. Los investigadores consiguieron extraer información de la memoria del servidor anfitrión y, en entornos controlados de laboratorio, provocar su caída y ejecutar código con privilegios elevados.

    El hallazgo surgió durante una investigación relacionada con la plataforma de aislamiento de aplicaciones de Vercel. La empresa confirmó que se había demostrado una fuga de memoria del anfitrión en su entorno de producción, mientras que los ataques de ejecución de código se reprodujeron en sistemas controlados por los investigadores. Vercel también señaló que las investigaciones no demostraron acceso a archivos o datos de aplicaciones de sus clientes.

    Lo relevante para las empresas no es memorizar los detalles técnicos del fallo, sino comprender su significado: una aplicación puede estar correctamente configurada y aun así depender de una infraestructura que presente vulnerabilidades fuera de su control.

    Esto no significa que todos los VPS sean inseguros ni que todos los servidores Linux estén afectados. La exposición depende de las versiones utilizadas, la configuración de la plataforma y las medidas de protección implementadas por cada proveedor.

    El verdadero riesgo aparece cuando el VPS sostiene tu negocio

    Imaginemos una empresa comercial que utiliza un VPS para alojar su sistema de inventarios y facturación. Durante meses, el servicio funciona sin problemas. Los empleados acceden diariamente, registran ventas y consultan información de sus clientes. Con el tiempo, ese servidor pasa de ser una herramienta tecnológica a convertirse en un elemento indispensable para la operación.

    Ahora imaginemos que una vulnerabilidad afecta al sistema físico que hospeda ese VPS. La empresa podría experimentar una interrupción del servicio o, en un escenario de compromiso más grave, verse expuesta a riesgos sobre la confidencialidad e integridad de su información.

    El impacto dejaría de ser exclusivamente informático. Los trabajadores podrían perder acceso al sistema, retrasarse las facturas, acumularse pedidos pendientes y detenerse procesos que dependen de esa aplicación.

    Y aquí aparece una pregunta importante: ¿quién está encargado de proteger la infraestructura que sostiene ese sistema?

    Muchos proveedores de VPS ofrecen los recursos necesarios para ejecutar aplicaciones, pero no necesariamente incluyen administración del sistema operativo, seguimiento de vulnerabilidades, pruebas de recuperación o acompañamiento especializado ante incidentes. Estos servicios pueden existir, aunque normalmente dependen del plan contratado y de las responsabilidades acordadas.

    Por eso, elegir un VPS únicamente por su precio mensual puede resultar insuficiente cuando lo que se aloja es una aplicación crítica para la empresa.

    Estar actualizado no siempre significa estar protegido

    Una de las enseñanzas más importantes de PwnEscape está relacionada con las actualizaciones de seguridad.

    Los fabricantes de sistemas operativos y los investigadores trabajan continuamente para descubrir y corregir vulnerabilidades. Sin embargo, publicar una corrección no significa que todos los servidores del mundo comiencen inmediatamente a utilizarla.

    En numerosos entornos Linux, por ejemplo, una actualización puede quedar instalada sin que el servidor empiece a utilizar la nueva versión del kernel hasta realizar un reinicio. Si ese mantenimiento se posterga indefinidamente, parte de las correcciones puede permanecer sin activarse.

    También hay situaciones en las que el fabricante todavía está evaluando si determinadas versiones de su sistema están afectadas. Al 20 de octubre de 2026, Canonical mantiene el estado Needs evaluation para el paquete principal del kernel de Ubuntu 24.04 frente a CVE-2026-99999. Esto significa que la evaluación oficial continúa pendiente, no que el sistema haya sido declarado seguro.

    Esta diferencia suele pasar inadvertida para las empresas que contratan infraestructura sin administración. El servidor puede seguir funcionando durante meses, mientras las tareas de mantenimiento y revisión de seguridad quedan pendientes.

    La seguridad, por tanto, no depende exclusivamente de disponer de actualizaciones. Depende también de contar con personas y procedimientos que evalúen cuándo aplicarlas, cómo hacerlo y cómo comprobar que realmente han quedado activas.

    ¿Qué puede hacer una empresa para reducir su exposición?

    La primera medida es identificar qué aplicaciones importantes dependen de servidores virtuales y conocer quién se responsabiliza de su mantenimiento. No hace falta dominar Linux para solicitar esta información. El proveedor debería poder explicar qué controles utiliza para proteger el sistema anfitrión, cómo atiende las vulnerabilidades críticas y qué proceso sigue para instalar actualizaciones de seguridad.

    En el caso concreto de PwnEscape, conviene solicitar una confirmación del estado de los servidores frente a CVE-2026-99999, incluyendo la evaluación del fabricante y la aplicación de una versión corregida cuando corresponda. No basta con recibir una respuesta genérica indicando que el servidor está actualizado.

    También es importante comprobar que existen copias de seguridad independientes de la infraestructura principal. Pero tener respaldos no es lo mismo que garantizar la recuperación. Una empresa debería conocer cuánto tiempo tomaría restaurar sus aplicaciones y si esas copias se han probado realmente.

    Mientras un fabricante publica o valida una corrección, el proveedor técnico debe evaluar medidas temporales para reducir la exposición, especialmente en plataformas que alojan cargas de distintos clientes. Las medidas concretas dependen de la arquitectura utilizada y no sustituyen la instalación del parche correspondiente.

    Finalmente, conviene establecer ventanas de mantenimiento y procedimientos de recuperación. Reiniciar un servidor de producción sin planificación puede generar sus propios problemas, pero postergar indefinidamente los reinicios también puede acumular riesgos.

    La recomendación fundamental es sencilla: pide a tu proveedor evidencia de cómo mantiene, protege y recupera la infraestructura donde funciona tu negocio.

    ¿Ha llegado el momento de considerar una nube privada administrada?

    Un VPS sigue siendo una solución válida para muchas aplicaciones y proyectos. No obstante, cuando una empresa depende de su infraestructura para vender, facturar, atender clientes o mantener procesos esenciales, la decisión ya no debería centrarse exclusivamente en memoria, almacenamiento y precio.

    En ese escenario cobra importancia una infraestructura diseñada según las necesidades del negocio, acompañada de administración, monitoreo, mantenimiento y procedimientos de continuidad.

    Una nube privada administrada puede ofrecer un enfoque diferente, con recursos y controles definidos de acuerdo con las necesidades de cada organización. Esto permite establecer responsabilidades claras sobre la infraestructura, la atención de incidentes y la recuperación de los servicios, de acuerdo con las condiciones contratadas.

    Por supuesto, una nube privada tampoco está libre de vulnerabilidades. Su valor no reside en prometer inmunidad ante los ataques, sino en permitir una estrategia de seguridad y operación acorde con la importancia de las aplicaciones alojadas.

    La diferencia entre contratar capacidad de cómputo y contratar un servicio de infraestructura administrada puede resultar decisiva cuando ocurre un incidente.

    La seguridad no debería depender de que algo falle primero

    PwnEscape terminará teniendo las correcciones y medidas de protección correspondientes, como ocurre con muchas vulnerabilidades importantes. Pero no será la última falla de seguridad que afecte a servidores empresariales.

    Cada nueva vulnerabilidad recuerda que la infraestructura tecnológica necesita atención constante, incluso cuando aparentemente todo funciona bien.

    Para una empresa, la pregunta no debería ser únicamente cuánto cuesta mantener encendido su servidor, sino cuánto depende de él y quién se responsabiliza de protegerlo.

    Un servidor económico puede ser suficiente para una aplicación secundaria. Cuando de él depende la continuidad del negocio, el verdadero valor está en la seguridad, la administración y la capacidad de recuperación.

    ¿Tu empresa depende de un VPS para seguir operando?

    Si tu sistema de facturación, ERP, plataforma comercial o aplicación crítica funciona en un VPS, puede ser un buen momento para revisar si la infraestructura actual responde a las necesidades de tu negocio.

    Nettix ofrece soluciones de nube privada administrada orientadas a empresas que necesitan continuidad, seguridad y soporte especializado. Su equipo puede ayudarte a evaluar la infraestructura existente y las alternativas para migrar tus aplicaciones.

    Conoce las soluciones disponibles en tu país:

    Nettix Perú — Nube privada y migración de servidores

    Nettix México — Infraestructura en nube privada administrada

    La prevención comienza mucho antes de que ocurra el próximo incidente.

  • Contenedores Linux: qué son, cómo funcionan y para qué sirven

    Contenedores Linux: qué son, cómo funcionan y para qué sirven

    Cuando visitamos una página web, usamos un sistema empresarial o abrimos una aplicación, rara vez pensamos en todo lo que ocurre detrás. Para nosotros simplemente funciona. Pero detrás de esa aplicación puede haber un servidor, una base de datos, varias librerías, una determinada versión de PHP, Java o Node.js, configuraciones de red, certificados, almacenamiento y muchos otros componentes que deben trabajar juntos.

    Y ahí aparece uno de los problemas clásicos de la informática: ¿cómo logramos que una aplicación funcione igual aunque cambiemos de servidor?

    Una de las respuestas más utilizadas actualmente son los contenedores Linux. Aunque el nombre puede sonar bastante técnico, la idea que hay detrás es mucho más sencilla de lo que parece.

    Pensemos primero en una aplicación

    Imaginemos que una empresa desarrolla un sistema para gestionar pedidos. Ese sistema no funciona por sí solo. Puede necesitar:

    • una determinada versión de PHP;
    • algunas librerías;
    • una base de datos;
    • configuraciones específicas;
    • archivos adicionales;
    • determinadas variables del sistema.

    Ahora imaginemos que el desarrollador termina el proyecto y lo entrega al área de infraestructura. Allí aparece una frase bastante conocida en tecnología:

    “En mi computadora funciona.”

    El problema es que la computadora del desarrollador y el servidor de producción pueden ser muy diferentes. Quizás utilizan versiones distintas del software. Quizás falta una librería. Quizás existe una configuración diferente. Y una pequeña diferencia puede ser suficiente para que una aplicación deje de funcionar correctamente.

    Los contenedores nacieron, entre otras cosas, para reducir este tipo de problemas.

    Entonces, ¿qué es un contenedor?

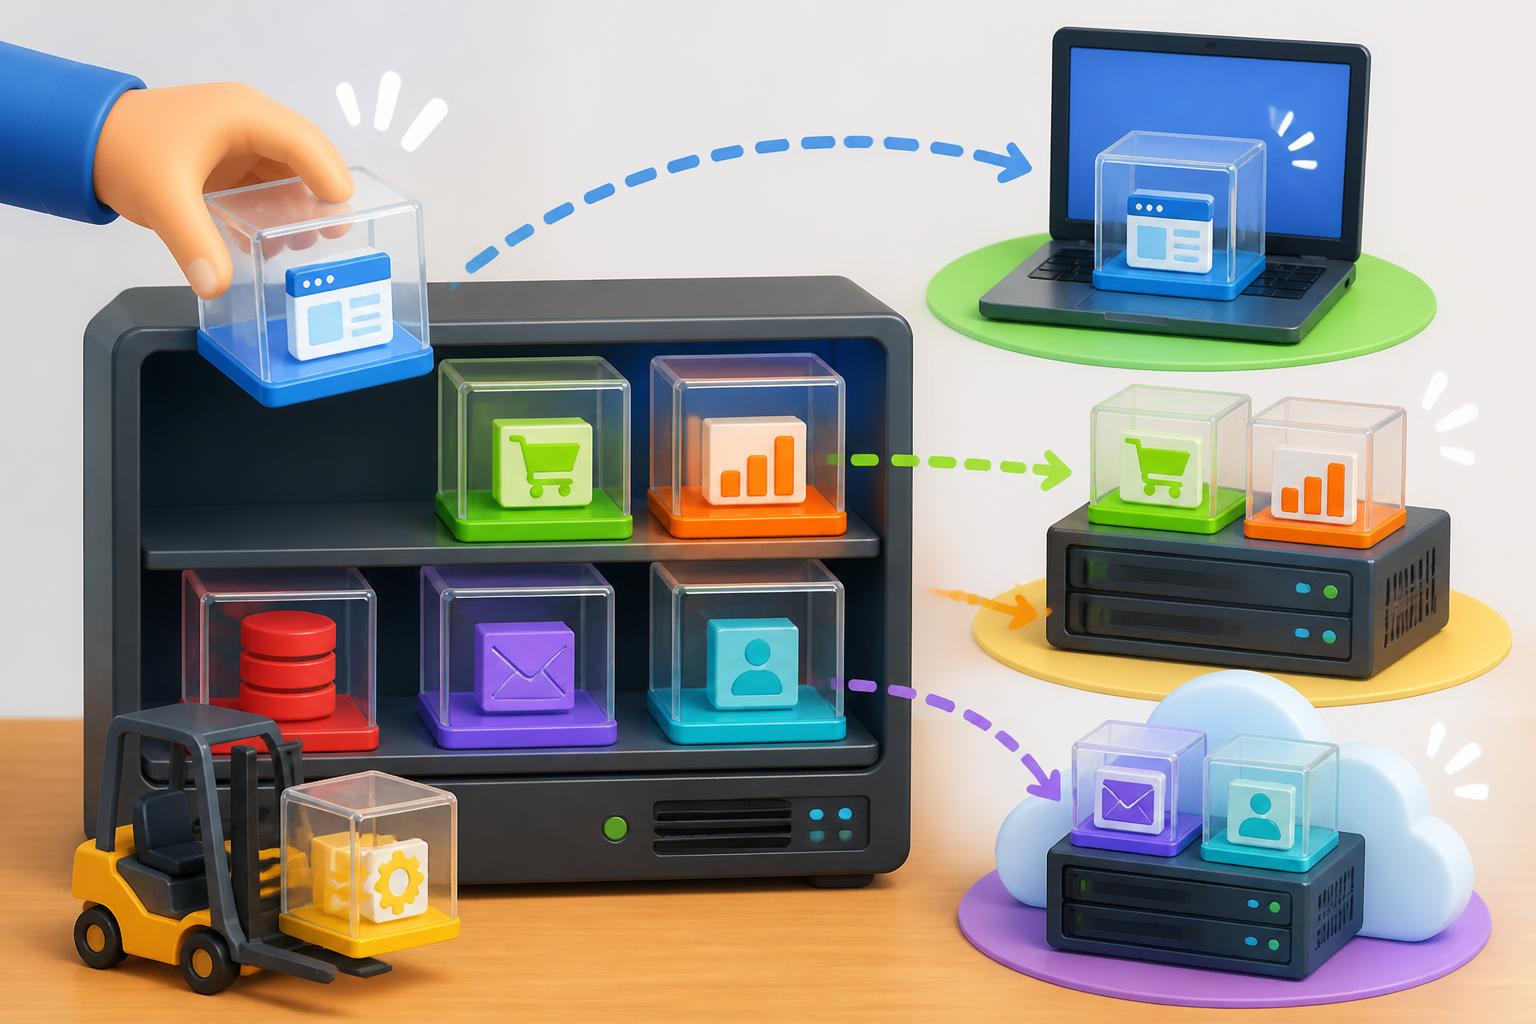
    Podemos imaginar un contenedor como una especie de caja preparada específicamente para ejecutar una aplicación. Dentro de esa caja se encuentran la aplicación y buena parte de los componentes que necesita para funcionar. De esta manera, en lugar de instalar y configurar manualmente todo cada vez que queremos desplegar la aplicación en un nuevo servidor, podemos llevarnos la caja completa. La aplicación llega acompañada de su entorno.

    No importa tanto si el servidor anterior era uno y el nuevo es otro: mientras la infraestructura sea compatible con esa tecnología de contenedores, el comportamiento será mucho más predecible. Ese es uno de los grandes atractivos de los contenedores.

    Una comparación sencilla: mudarse de casa

    Podemos imaginar una aplicación tradicional como una persona que se muda de casa llevando sus pertenencias por separado. Primero lleva los muebles. Después la ropa. Después los electrodomésticos. Luego descubre que en la nueva casa los enchufes son diferentes. O que falta una conexión. O que determinado mueble ya no entra.

    Con los contenedores, la idea se parece más a transportar una unidad previamente preparada, donde gran parte de lo necesario ya está organizado. Al llegar al nuevo lugar hay menos cosas que reconstruir.

    En informática esto puede significar menos diferencias entre el ambiente donde se desarrolla una aplicación y el servidor donde finalmente se ejecuta.

    ¿Un contenedor es una máquina virtual?

    No exactamente. Esta es probablemente una de las confusiones más frecuentes. Tanto una máquina virtual como un contenedor permiten separar aplicaciones, pero lo hacen de maneras diferentes.

    Una máquina virtual intenta comportarse como una computadora completa dentro de otra computadora. Tiene su propio sistema operativo, memoria asignada, almacenamiento y otros recursos. Por ejemplo, dentro de un servidor físico podríamos crear:

    • una máquina virtual con Linux;
    • otra con Windows;
    • otra con otro Linux diferente.

    Cada una funciona casi como una computadora independiente. Un contenedor es más ligero. En lugar de crear una computadora completa para cada aplicación, varios contenedores pueden compartir partes importantes del sistema operativo que existe debajo. Podríamos imaginarlo así:

    • Máquina virtual: una casa completa.
    • Contenedor: un departamento dentro de un edificio.

    Cada departamento está separado y tiene su propio espacio, pero todos utilizan la misma estructura principal del edificio. No es una comparación técnicamente perfecta, pero ayuda bastante a entender la diferencia.

    ¿Por qué los contenedores consumen menos recursos?

    Porque no necesitan crear un sistema operativo completo para cada aplicación. Imaginemos que queremos ejecutar diez aplicaciones diferentes.

    Con máquinas virtuales podríamos terminar teniendo diez sistemas operativos independientes funcionando al mismo tiempo. Cada uno consume memoria, espacio en disco y capacidad de procesamiento.

    Con contenedores, muchas de esas aplicaciones pueden compartir la misma base del sistema operativo. Eso permite aprovechar mejor un servidor.

    Por esta razón, en determinadas circunstancias, una misma infraestructura puede ejecutar una mayor cantidad de aplicaciones utilizando contenedores.

    Pero ¿cómo evita un contenedor que una aplicación interfiera con otra?

    Aquí aparece la parte un poco más técnica, aunque el concepto sigue siendo bastante sencillo. Linux posee mecanismos que permiten separar procesos y controlar cuánto puede utilizar cada uno. Dos de los más importantes se llaman:

    • namespaces;
    • cgroups.

    No es necesario memorizar estos nombres para entender los contenedores. Lo importante es entender qué hacen. Los namespaces ayudan a que cada contenedor vea su propio entorno. Los cgroups permiten controlar cuánta memoria, procesamiento y otros recursos puede consumir. En otras palabras, Linux crea una especie de frontera alrededor de cada aplicación. Esto permite que varias aplicaciones compartan un servidor sin mezclarse completamente entre ellas.

    ¿Dónde entra Docker en todo esto?

    Docker hizo populares los contenedores porque simplificó muchísimo su creación y utilización. Por eso muchas personas utilizan las palabras Docker y contenedor como si significaran exactamente lo mismo. Pero no es así. Un contenedor es la tecnología o el concepto. Docker es una de las herramientas que permite trabajar con ellos. Existen otras alternativas como Podman, LXC o containerd. Una comparación podría ser:

    • Contenedor es el concepto de automóvil.
    • Docker sería una marca o una plataforma que facilita utilizar ese automóvil.

    Docker tuvo un papel enorme en popularizar esta forma de desplegar aplicaciones.

    ¿Y qué es una imagen de Docker?

    Aquí aparece otro concepto frecuente. Antes de ejecutar un contenedor normalmente existe una imagen. Podemos imaginar la imagen como una plantilla. Dentro de ella se define qué necesita la aplicación para funcionar. Por ejemplo:

    • determinada versión de PHP;
    • determinadas librerías;
    • determinados archivos;
    • una configuración inicial.

    A partir de esa imagen podemos crear uno o muchos contenedores. La imagen sería el molde. El contenedor sería la instancia funcionando.

    Un ejemplo bastante cotidiano

    Supongamos que una empresa tiene una aplicación desarrollada en Laravel. La aplicación necesita PHP 8.3. El servidor actual utiliza PHP 8.3 y funciona perfectamente. Pero unos meses después otra aplicación instalada en ese mismo servidor necesita PHP 8.5. Comienzan entonces los posibles conflictos.

    • ¿Actualizamos PHP?
    • ¿Podría dejar de funcionar la primera aplicación?
    • ¿Instalamos dos versiones?
    • ¿Creamos otro servidor?

    Con contenedores podríamos tener algo parecido a esto:

    Aplicación A

    • PHP 8.3
    • Laravel
    • Conexión con SQL server
    • Sus propias dependencias

    Aplicación B

    • PHP 8.3
    • Laravel
    • Conexión con MySQL
    • Sus propias dependencias

    Ambas pueden vivir en el mismo servidor manteniendo separados sus entornos. Para las empresas que administran muchas aplicaciones, esta característica puede simplificar muchísimo las cosas.

    ¿Para qué se utilizan los contenedores?

    Actualmente pueden utilizarse prácticamente en cualquier tipo de aplicación. Pero existen algunos escenarios donde resultan especialmente útiles.

    Sitios Web

    Un sitio web puede ejecutarse dentro de un contenedor junto con la versión de PHP y las librerías que necesita.

    Aplicaciones empresariales

    Sistemas desarrollados en Laravel, Java, Python o Node.js pueden empaquetarse dentro de contenedores.

    Ambientes de desarrollo

    Un desarrollador puede trabajar con prácticamente el mismo entorno que después se utilizará en producción.

    Pruebas

    Es posible crear rápidamente un ambiente para probar una nueva versión de una aplicación y luego eliminarlo.

    Microservicios.

    Aplicaciones grandes pueden dividirse en componentes más pequeños que funcionan de manera independiente.

    Cada componente puede ejecutarse dentro de su propio contenedor.

    ¿Los contenedores sirven únicamente para grandes empresas?

    No. Esa es otra percepción bastante común. Muchas veces escuchamos hablar de Docker, Kubernetes y microservicios en proyectos enormes como Netflix, Google o grandes plataformas tecnológicas. Pero los contenedores también pueden resultar útiles en proyectos bastante pequeños. Por ejemplo:

    • una empresa podría tener un WordPress;
    • un sistema desarrollado en Laravel;
    • un pequeño ERP;
    • una API;
    • y una aplicación Node.js.

    Cada una podría ejecutarse dentro de su propio entorno sin necesidad de instalar todos los componentes directamente sobre el mismo sistema operativo. Esto facilita mantener separados los proyectos.

    ¿Y Kubernetes?

    Cuando se habla de contenedores, tarde o temprano aparece Kubernetes. El problema es que muchas veces se presentan ambos conceptos juntos y parece que fueran inseparables. No lo son, de hecho, podemos utilizar contenedores perfectamente sin Kubernetes. Kubernetes empieza a tener más sentido cuando tenemos una infraestructura mucho más grande. Imaginemos cientos de contenedores distribuidos entre distintos servidores. Entonces aparecen preguntas como:

    • ¿Dónde debería ejecutarse cada contenedor?
    • ¿Qué sucede si un servidor falla?
    • ¿Cómo levantamos automáticamente otra copia?
    • ¿Cómo distribuimos el tráfico?
    • ¿Cómo actualizamos cientos de aplicaciones?

    Kubernetes ayuda a automatizar este tipo de operaciones.

    Pero utilizar Kubernetes para una aplicación pequeña puede ser como utilizar un centro logístico de aeropuerto para organizar tres maletas. La herramienta es muy poderosa, pero también introduce complejidad.

    ¿Los contenedores reemplazan a las máquinas virtuales?

    No. En realidad, ambas tecnologías suelen trabajar juntas. Por ejemplo, una infraestructura podría ser:

    Servidor físico

    ↓

    Máquinas virtuales

    ↓

    Linux

    ↓

    Contenedores

    ↓

    Aplicaciones

    La máquina virtual proporciona un entorno aislado. Dentro de ella los contenedores permiten organizar las aplicaciones. Esta combinación es extremadamente común. Por eso la conversación no debería ser necesariamente: “¿Contenedores o máquinas virtuales?” Muchas veces la respuesta correcta es: “Los dos.”

    ¿Cuándo sigue teniendo sentido una máquina virtual?

    Las máquinas virtuales siguen siendo muy útiles. Por ejemplo, cuando necesitamos ejecutar diferentes sistemas operativos. Podríamos tener:

    • Windows Server;
    • Ubuntu;
    • Debian;
    • FreeBSD.

    También pueden resultar más adecuadas para aplicaciones antiguas que esperan funcionar dentro de una máquina completa. O cuando necesitamos entregar al cliente control total sobre un sistema operativo. Los contenedores no eliminan estas necesidades. Simplemente resuelven otro tipo de problema.

    ¿Qué ventajas tienen entonces los contenedores?

    Para una empresa, probablemente las ventajas más fáciles de entender sean estas.

    Utilizan menos recursos.

    Al compartir parte del sistema operativo pueden ser considerablemente más ligeros que una máquina virtual.

    Son fáciles de replicar.

    Si tenemos una aplicación funcionando dentro de un contenedor, podemos crear otra instancia utilizando la misma configuración.

    Facilitan migraciones.

    Mover una aplicación entre servidores puede ser más sencillo si su entorno está correctamente empaquetado.

    Reducen conflictos entre aplicaciones.

    Cada aplicación puede utilizar sus propias dependencias.

    Facilitan las actualizaciones.

    Podemos crear una nueva versión del contenedor y reemplazar la anterior.

    Ayudan a mantener entornos consistentes.

    Desarrollo, pruebas y producción pueden utilizar configuraciones mucho más parecidas.

    Pero los contenedores tampoco son magia

    Existe una tendencia en tecnología a presentar algunas herramientas como soluciones universales. Los contenedores no lo son. Utilizarlos correctamente requiere pensar en otras partes de la infraestructura. Por ejemplo:

    • almacenamiento;
    • bases de datos;
    • seguridad;
    • redes;
    • backups;
    • monitoreo;
    • actualizaciones.

    Especialmente importante es el almacenamiento. Un contenedor debería poder desaparecer y ser reemplazado. Por eso la información importante no debería depender exclusivamente del interior del contenedor. Los datos deben almacenarse en sistemas persistentes y contar con copias de seguridad.

    El problema no suele ser crear el contenedor

    Crear un contenedor puede ser relativamente sencillo. El verdadero trabajo aparece después.

    • ¿Quién actualiza el servidor?
    • ¿Quién monitorea la aplicación?
    • ¿Quién revisa el consumo de memoria?
    • ¿Quién configura los backups?
    • ¿Quién administra los certificados SSL?
    • ¿Quién detecta que un servicio dejó de funcionar?
    • ¿Quién revisa la seguridad?

    Aquí encontramos una diferencia importante entre tener tecnología y tener infraestructura administrada. Una empresa puede instalar Docker en un VPS en pocos minutos. Eso no significa que automáticamente tenga una plataforma confiable para alojar aplicaciones.

    Entonces, ¿necesito un VPS o un contenedor?

    En realidad, esa pregunta puede estar planteada de manera incorrecta. Un VPS es infraestructura. Un contenedor es una forma de ejecutar una aplicación. Podemos perfectamente ejecutar contenedores dentro de un VPS. La verdadera pregunta sería:

    ¿Quiero administrar yo mismo toda la infraestructura o simplemente quiero que mi aplicación funcione?

    Son dos necesidades diferentes. Un desarrollador puede querer acceso completo al servidor. Otra empresa puede preferir simplemente entregar su aplicación y dejar que otra persona se encargue de mantener la infraestructura.

    El hosting está cambiando

    Durante muchos años el hosting funcionaba de una manera bastante sencilla. Una empresa contrataba espacio en un servidor y colocaba allí su página web. Pero las aplicaciones actuales son mucho más variadas. Hoy podemos tener:

    • WordPress,
    • Moodle,
    • Laravel,
    • Node.Js,
    • Java
    • Python,
    • ERP,
    • CRM,
    • APIs,

    Cada aplicación puede tener requisitos completamente diferentes. Por eso el concepto de hosting también está evolucionando. Ya no se trata únicamente de almacenar páginas web. Cada vez se trata más de proporcionar entornos preparados para ejecutar aplicaciones. Y los contenedores tienen un papel importante en esa evolución.

    Un ejemplo práctico

    Imaginemos una empresa que desarrolla un ERP en Laravel. Podría contratar un VPS. Después alguien tendría que:

    • Instalar Linux
    • Configurar PHP,
    • Configurar el servidor web,
    • Instalar la base de de datos,
    • Configurar certificados SSL
    • Crear las copias de respaldo,
    • Configurar la seguridad,
    • Monitorear el servidor,
    • Mantener todo actualizado,

    Otra alternativa sería separar las responsabilidades. El desarrollador mantiene la aplicación. La infraestructura mantiene el entorno donde esa aplicación funciona. Podríamos tener:

    Internet

    ↓

    Proxy reverso

    ↓

    Aplicación dentro de un contenedor

    ↓

    Base de datos

    ↓

    Almacenamiento

    ↓

    Backups

    El desarrollador puede concentrarse en su software. El proveedor de infraestructura puede concentrarse en servidores, redes, seguridad y disponibilidad.

    Entonces, ¿qué son realmente los contenedores?

    Quitando todos los términos técnicos, podemos resumirlos de una manera bastante sencilla. Los contenedores son una forma de empaquetar y ejecutar aplicaciones dentro de entornos aislados y reproducibles. Permiten separar aplicaciones entre sí. Permiten utilizar mejor los recursos de un servidor. Facilitan mover aplicaciones. Y ayudan a reducir las diferencias entre un ambiente de desarrollo y uno de producción. No reemplazan completamente a las máquinas virtuales. Tampoco hacen innecesaria la administración de servidores. Pero se han convertido en una de las piezas fundamentales de la infraestructura moderna. Y posiblemente esa sea la mejor forma de entenderlos:

    una máquina virtual organiza servidores; un contenedor ayuda a organizar aplicaciones.

    En SCIWebHosting seguiremos explorando estas tecnologías desde una perspectiva práctica: qué problema resuelven, cuándo tiene sentido utilizarlas y cuándo una solución más sencilla puede ser mejor.

  • Cómo nació SCI Editorial Blocks: una forma más simple de publicar mejor en WordPress

    Cómo nació SCI Editorial Blocks: una forma más simple de publicar mejor en WordPress

    SCI Editorial Blocks nació de algo bastante cotidiano: pasar muchas horas escribiendo, editando y publicando en WordPress.

    Con el tiempo empezamos a notar que ciertas decisiones se repetían demasiado. Cómo ayudar al lector a ubicarse dentro de un artículo largo, cómo destacar una idea importante sin romper la lectura, cómo mostrar contenido relacionado, cómo dar contexto rápidamente o cómo mantener una estructura editorial consistente sin reconstruirla cada vez desde cero.

    Al principio resolvíamos cada necesidad de manera independiente. Un bloque por aquí, una clase CSS por allá, algún elemento copiado de una publicación anterior. Nada especialmente grave. Pero cuando publicas de forma constante, esas pequeñas fricciones empiezan a acumularse.

    Y ahí apareció la pregunta que terminó dando origen al proyecto: si estas cosas forman parte de nuestra manera habitual de publicar, ¿por qué no convertirlas en herramientas propias dentro de Gutenberg?

    Así empezó SCI Editorial Blocks.

    Lo más leído: ayudar a que una buena lectura lleve a otra

    Uno de los primeros problemas que queríamos resolver no estaba dentro del artículo, sino justo después de él.

    Cuando alguien termina de leer una publicación, muchas veces ese es el mejor momento para ofrecerle otro contenido relacionado con los temas que ya le interesan. Sin embargo, hacerlo manualmente implica decidir enlaces, actualizar bloques y mantener esas recomendaciones con el tiempo. De ahí nació Lo más leído.

    La idea es sencilla: aprovechar el propio contenido del sitio para darle continuidad a la lectura sin que cada artículo tenga que construirse como una pequeña landing page.

    Para nosotros esto también forma parte de la experiencia editorial. Un buen artículo no debería sentirse como un callejón sin salida. Si alguien llegó buscando información sobre WordPress, infraestructura o seguridad, probablemente haya otras publicaciones que puedan resultarle útiles.

    La navegación interna deja entonces de ser solamente un tema de SEO y empieza a ser parte de la experiencia del lector.

    En este articulo: orientarse antes de empezar a leer

    A medida que los artículos de SCI fueron creciendo apareció otro problema muy natural.

    No todo el mundo lee de principio a fin. Algunas personas quieren entender primero de qué trata el contenido. Otras llegan buscando una sección concreta. Y cuando un artículo tiene varios subtítulos, desplazarse por él hasta encontrar lo importante no siempre es la mejor experiencia. Por eso incorporamos En este articulo, nuestro TOC o tabla de contenidos.

    La intención no era llenar la página de navegación, sino ofrecer una pequeña brújula.

    El lector puede ver rápidamente cómo está estructurada la publicación y saltar hacia la parte que le interesa. Y para quien decide leerla completa, sirve simplemente para entender el recorrido antes de comenzar.

    Durante el desarrollo también aprendimos algo importante: el bloque no tenía por qué imponer su propio diseño.

    Si Gutenberg ya permite controlar fondos, grupos y composiciones, preferíamos que “En este artículo” pudiera integrarse con ellos en lugar de comportarse como un elemento aislado.

    Ese tipo de decisiones fueron definiendo bastante la filosofía del plugin.

    Callout: cuando una idea necesita detener la lectura por un momento

    También había otro patrón que repetíamos constantemente.

    Dentro de un artículo técnico hay momentos donde una idea necesita un poco más de espacio. Puede ser una advertencia, una conclusión, una recomendación práctica o un dato que cambia la forma de interpretar lo que viene después.

    • Podíamos usar negritas.
    • Podíamos poner una cita.
    • Podíamos crear una caja manualmente.

    Pero ninguna de esas soluciones expresaba exactamente lo que queríamos hacer. Así apareció el Callout.

    No queríamos algo estridente. La intención era mucho más editorial: crear una pausa. Un pequeño momento dentro del artículo donde el lector entiende que vale la pena detenerse unos segundos antes de continuar.

    De hecho, esta propia publicación es una buena forma de ver cómo funciona. Preferimos mostrar los bloques dentro del contexto para el que fueron creados antes que diseñar una página de demostración artificial.

    En resumen: entender primero, profundizar después

    Otro elemento que usamos bastante en SCI es el resumen inicial. Hay artículos donde la respuesta principal puede explicarse en pocas líneas, aunque después necesitemos varios párrafos para desarrollar contexto, matices y ejemplos.

    Ahí entra En resumen.

    La idea es sencilla: permitir que quien llega buscando una respuesta rápida pueda encontrarla sin obligarlo a recorrer toda la publicación. Pero durante el desarrollo apareció una segunda cuestión. WordPress ya tiene un extracto. Entonces, si ese extracto ya explica correctamente el contenido, ¿por qué volver a escribir lo mismo?

    Eso nos llevó a trabajar en la posibilidad de reutilizar el excerpt del artículo dentro del propio bloque.

    Es una de esas mejoras que parecen pequeñas hasta que empiezas a publicar constantemente. Eliminar una tarea repetitiva aquí y otra allá termina haciendo que todo el proceso sea bastante más agradable.

    Los subtítulos también forman parte del producto

    Una de las cosas que hemos aprendido publicando durante estos años es que los subtítulos no son simplemente elementos de formato. Son descansos.

    Especialmente cuando escribimos para gerentes, responsables de TI o personas que probablemente estén leyendo entre reuniones, correos y otras tareas.

    Un artículo puede contener información muy buena y aun así resultar pesado si se presenta como una pared continua de texto. Por eso SCI Editorial Blocks también parte de una idea más amplia: utilizar la estructura del documento como parte de la experiencia.

    Los subtítulos permiten anticipar el contenido, volver a encontrar una idea después y, junto con el TOC, transformar artículos extensos en textos mucho más fáciles de recorrer. No queremos hacer que los artículos parezcan más cortos. Queremos hacer que se sientan más fáciles de leer.

    No queríamos otro constructor de páginas

    Conforme aparecían nuevas posibilidades hubo un momento donde tuvimos que decidir hasta dónde queríamos llegar. Porque desarrollar bloques es tentador. Una vez que tienes uno, empiezas a imaginar controles adicionales, variantes, colores, bordes, iconos, espaciados y decenas de configuraciones.

    Y antes de darte cuenta estás construyendo otro page builder. No era nuestro objetivo. Fue entonces cuando decidimos que SCI Editorial Blocks debía seguir siendo una herramienta editorial. Por eso fue que adoptamos una regla bastante simple: reuse first.

    • Si WordPress ya sabe hacerlo, intentamos utilizarlo.
    • Si Gutenberg ya ofrece un control, no necesitamos inventar otro.
    • Si un Grupo puede controlar un fondo, no tiene sentido obligar al bloque a hacerlo.

    Eso también nos permite reducir otra cosa que habíamos ido acumulando con el tiempo: CSS personalizado.

    Menos CSS, más intención

    Como ocurre en muchos sitios WordPress que evolucionan durante años, SciWebHosting había ido acumulando pequeñas reglas de CSS. Cada una resolvía algo. El problema aparecía después, cuando intentábamos recordar por qué existía.

    Mover determinados patrones hacia bloques nos permite darles un propósito claro. El Callout es un Callout. El TOC es el TOC. “Lo más leído” tiene una función concreta. Ya no son simplemente estilos dispersos dentro del sitio. Son componentes.

    Y eso hace que sea mucho más fácil mantenerlos, evolucionarlos y saber dónde tocar cuando queremos cambiar algo.

    Este artículo también es parte de la demostración

    Quizá la mejor forma de explicar SCI Editorial Blocks sea esta misma publicación.

    Aquí puedes ver la lógica que estamos intentando construir: subtítulos que dan ritmo a la lectura, navegación mediante “En este artículo”, bloques de resumen, Callouts para destacar ideas y elementos que permiten continuar explorando contenido después de terminar. No desarrollamos estos bloques para una demo. Los desarrollamos porque queríamos utilizarlos nosotros. Esa diferencia nos parece importante.

    Cuando una herramienta nace del uso cotidiano, sus prioridades suelen ser distintas. No intenta tener cien opciones. Intenta eliminar diez pequeñas molestias que encuentras todos los días.

    Y el código está en GitHub

    También quisimos que SCI Editorial Blocks pudiera verse por dentro. El código del proyecto está disponible en GitHub, donde se puede revisar su estructura, seguir su evolución y entender cómo hemos ido resolviendo cada una de estas necesidades dentro de Gutenberg.

    Para nosotros tiene sentido hacerlo así. SciWebHosting siempre ha sido un espacio para compartir cosas que aprendemos trabajando con tecnología. A veces hablamos de infraestructura, otras de seguridad, hosting o WordPress. Esta vez la experiencia terminó convirtiéndose en software. Y en lugar de limitarnos a enseñar el resultado, también queremos enseñar cómo lo construimos.

    Lo que empezó como pequeñas molestias cambió nuestra forma de publicar

    Mirando hacia atrás, quizá lo más interesante de SCI Editorial Blocks no sean los bloques.

    Es el proceso. Empezamos intentando eliminar pequeñas fricciones al publicar. Eso nos obligó a revisar cómo escribíamos, cómo organizábamos la información y qué cosas realmente necesitaba un lector dentro de un artículo.

    De ahí aparecieron Lo más leído, En este artículo, En resumen, Callout y los distintos recursos para destacar ideas y puntos clave. No porque quisiéramos llenar Gutenberg de funcionalidades. Sino porque cada uno resolvía algo que habíamos encontrado utilizando nuestro propio sitio. Y esa sigue siendo probablemente la regla más importante para todo lo que estamos construyendo alrededor de SCI: primero usamos. Después observamos qué molesta. Y recién entonces decidimos si vale la pena convertirlo en software.

  • CAPEX vs OPEX en infraestructura TI: comprar servidores o consumir nube

    CAPEX vs OPEX en infraestructura TI: comprar servidores o consumir nube

    Comprar servidores solía ser una de las decisiones más normales dentro de un departamento de tecnología. Se definía la capacidad necesaria, se solicitaban cotizaciones, se aprobaba la inversión y el equipo terminaba funcionando durante varios años dentro de una oficina o un datacenter.

    Ese modelo sigue existiendo y puede continuar siendo válido. Sin embargo, la expansión de servicios cloud y de infraestructura administrada introdujo una alternativa diferente: en lugar de comprar capacidad tecnológica por adelantado, las empresas pueden consumirla como un servicio mensual. Detrás de esa diferencia aparece una discusión que no es únicamente técnica. También es financiera.

    CAPEX y OPEX describen dos maneras distintas de financiar infraestructura, pero para un gerente de TI representan algo todavía más importante: dos formas diferentes de asumir riesgo.

    Cuando la infraestructura se compra por adelantado

    CAPEX, o gasto de capital, aparece cuando la empresa compra un activo que utilizará durante varios años.

    Un servidor es el ejemplo clásico.

    La compañía realiza una inversión inicial relativamente alta y espera aprovechar ese equipo durante cuatro, cinco o más años. Desde una perspectiva contable, ese activo suele depreciarse a lo largo del tiempo.

    El atractivo es evidente.

    Una vez adquirido el hardware, la empresa dispone de capacidad propia y puede utilizarla sin pagar una renta mensual por el equipo.

    Pero existe un detalle importante: la capacidad debe comprarse antes de saber exactamente cuánto se utilizará. Si una empresa estima que necesitará 256 GB de memoria dentro de tres años, probablemente comprará esa capacidad desde el inicio, aunque durante los primeros meses solamente utilice una fracción.

    En otras palabras, CAPEX obliga muchas veces a comprar hoy la infraestructura que quizá será necesaria mañana.

    OPEX cambia la forma de crecer

    OPEX representa gastos operativos recurrentes. En infraestructura tecnológica aparece cuando la empresa contrata capacidad como servicio: servidores virtuales, almacenamiento, backups administrados o plataformas de nube privada.

    En lugar de realizar una inversión grande al inicio, la organización paga periódicamente por la capacidad contratada. Esto modifica la lógica de crecimiento.

    Si una aplicación necesita más memoria dentro de seis meses, no necesariamente hace falta comprar otro servidor. En una infraestructura virtualizada puede bastar con ampliar recursos.

    Desde la perspectiva financiera, esto reduce la necesidad de anticipar grandes inversiones. Desde la perspectiva técnica, también permite adaptar la infraestructura con mayor rapidez.

    Ese modelo es especialmente atractivo para empresas que no quieren convertir cada aumento de capacidad en un nuevo proyecto de adquisición de hardware.

    El CAPEX barato puede convertirse en OPEX oculto

    Uno de los errores más frecuentes al comparar infraestructura propia con servicios cloud consiste en mirar únicamente el precio del servidor. Supongamos que una empresa compra un equipo por varios miles de dólares.

    A primera vista, dividir ese costo entre cinco años puede producir una cifra mensual muy atractiva.

    Pero el servidor no funciona aislado. Necesita espacio físico, energía, conectividad, UPS, climatización, almacenamiento, copias de seguridad y monitoreo. También necesita personas que lo administren.

    Cuando se aloja en un datacenter aparecen costos de housing o colocation. Cuando está dentro de las instalaciones de la empresa aparecen otros costos asociados a energía, refrigeración y continuidad eléctrica. Además, durante cinco años seguramente habrá que reemplazar algún disco, ampliar memoria o resolver incidentes.

    Por eso una comparación financiera seria debería calcular el costo total de propiedad, conocido como TCO.

    La compra del servidor es solamente una parte de ese cálculo.

    El verdadero costo es lo que ocurre cuando algo falla

    Hay un componente que casi nunca aparece en la primera cotización: el costo de una interrupción. Si un servidor físico falla, alguien tiene que identificar el problema, conseguir el repuesto, reemplazar el componente y recuperar los sistemas.

    Dependiendo de la infraestructura, ese proceso puede ser trivial o convertirse en varias horas de indisponibilidad. Cuando las aplicaciones soportan ventas, operaciones, facturación, atención al cliente o procesos internos críticos, esas horas tienen un costo real.

    Este punto es especialmente relevante al evaluar servicios de nube privada administrada. El valor ya no está solamente en “tener una máquina virtual”, sino en reducir la dependencia operativa de una pieza específica de hardware.

    Proveedores como Nettix en Perú y México trabajan precisamente bajo ese modelo: ofrecer capacidad virtualizada y administrada para que la empresa pueda concentrarse más en sus sistemas y menos en la renovación, falla o mantenimiento físico de los servidores.

    OPEX tampoco significa pagar por todo sin control

    Mover infraestructura a un modelo de gasto operativo no garantiza eficiencia automáticamente.

    Un entorno cloud mal dimensionado puede resultar innecesariamente costoso. Máquinas virtuales sobredimensionadas, almacenamiento que nadie revisa o recursos contratados que permanecen ociosos pueden hacer crecer la factura sin aportar valor. La ventaja del modelo OPEX aparece cuando existe disciplina técnica.

    La empresa puede revisar periódicamente qué recursos utiliza, ajustar capacidad y alinear mejor el gasto con las necesidades reales del negocio.

    En una nube privada bien administrada, esa conversación debería ser continua: cuánto CPU se está utilizando, cuánto almacenamiento está creciendo, qué máquinas realmente necesitan más memoria y qué recursos pueden mantenerse estables.

    No todas las empresas necesitan dejar de comprar servidores

    Sería un error plantear esta discusión como si CAPEX perteneciera al pasado y OPEX fuera siempre el futuro.

    Hay escenarios donde comprar hardware sigue siendo una excelente decisión.

    Una carga intensiva, estable y altamente predecible puede aprovechar muy bien un servidor adquirido por la empresa. También hay organizaciones que necesitan control físico por razones técnicas, regulatorias o de arquitectura.

    El punto es que la decisión debería ser deliberada.

    Comprar un servidor porque “siempre hemos comprado servidores” no es una estrategia. Del mismo modo, migrar a la nube simplemente porque todo el mercado habla de cloud tampoco lo es.

    La comparación correcta tiene que considerar el ciclo de vida completo de la infraestructura.

    La utilización cambia completamente la ecuación

    Existe una variable que suele tener más impacto que cualquier otra: cuánto se utiliza realmente la infraestructura.

    Un servidor propio utilizado permanentemente al 70 u 80 % puede tener mucho sentido económico.

    Un servidor comprado para utilizarse al 15 % durante varios años probablemente no sea una inversión tan eficiente.

    La virtualización intenta precisamente mejorar esa utilización compartiendo capacidad física entre distintas cargas.

    Desde el punto de vista del negocio, eso permite aproximar mejor el costo de infraestructura al consumo real.

    También reduce uno de los problemas históricos del CAPEX: sobredimensionar hoy porque no sabemos cuánto necesitaremos mañana.

    De comprar equipos a comprar capacidad operativa

    Aquí es donde la discusión entre CAPEX y OPEX se vuelve realmente interesante para un gerente de TI.

    Cuando una empresa compra un servidor, compra un activo.

    Cuando contrata infraestructura administrada, compra capacidad operativa.

    La diferencia está en que el segundo modelo puede incluir componentes que antes estaban dispersos entre diferentes presupuestos y responsabilidades: infraestructura, almacenamiento, virtualización, backups, monitoreo, soporte y renovación tecnológica.

    Eso no significa que todos esos elementos estén incluidos automáticamente en cualquier servicio cloud. Hay que revisar muy bien qué ofrece cada proveedor.

    Pero sí cambia la forma de evaluar la inversión.

    En vez de comparar “servidor de US$5,000 contra mensualidad de US$300”, la comparación debería ser “cinco años de operación completa contra cinco años de capacidad como servicio”.

    Ahí suelen aparecer números muy distintos.

    Una decisión empresarial, no solamente tecnológica

    La discusión entre CAPEX y OPEX suele presentarse como un tema contable, pero en realidad afecta directamente a la estrategia tecnológica.

    CAPEX ofrece propiedad y previsibilidad cuando las cargas son estables. OPEX ofrece flexibilidad cuando la demanda cambia o cuando la empresa prefiere trasladar parte del riesgo operativo a un proveedor especializado.

    Muchas organizaciones terminarán utilizando ambos modelos.

    Lo importante es entender qué problemas quiere resolver cada uno.

    En mercados como Perú y México, donde empresas de todos los tamaños siguen operando servidores propios y servicios de housing, la nube privada aparece como un punto intermedio interesante: conserva buena parte del control que busca un departamento de TI, pero evita que cada crecimiento, falla o renovación tenga que empezar con una compra de hardware.

    Nettix Perú y Nettix México son ejemplos de este tipo de modelo regional, donde la infraestructura puede consumirse como servicio sin necesariamente llevar a la empresa hacia una nube pública masiva o hacia una arquitectura completamente estandarizada.

    Al final, la pregunta no es si CAPEX u OPEX es mejor.

    La pregunta es qué modelo permite que la infraestructura acompañe al negocio con menos fricción, menos riesgo y una estructura de costos que la empresa pueda sostener durante los próximos años.

  • Housing, servidor dedicado o nube privada: ¿qué opción conviene para una empresa?

    Housing, servidor dedicado o nube privada: ¿qué opción conviene para una empresa?

    Durante años, muchas empresas crecieron de una forma bastante predecible: empezaron con un hosting, luego pasaron a un VPS, después compraron un servidor y finalmente terminaron alojándolo en un datacenter. Ese camino tuvo sentido durante mucho tiempo porque daba una sensación clara de control: el servidor era propio, el hardware estaba identificado y la infraestructura parecía estar bajo dominio directo de la empresa.

    Hoy la decisión es más compleja. Ya no se trata solamente de saber dónde está el servidor, sino de entender cuánto esfuerzo operativo, riesgo y capital está dispuesto a asumir el negocio para mantener esa infraestructura funcionando.

    Housing, servidor dedicado y nube privada resuelven problemas parecidos, pero lo hacen de maneras muy distintas. Para un gerente de TI, elegir entre estas opciones implica mirar mucho más allá de la potencia del procesador o la cantidad de memoria RAM.

    Housing: control total, responsabilidad total

    El housing, también conocido como colocation en muchos mercados, consiste básicamente en llevar un servidor propio a un datacenter y contratar espacio, energía, conectividad y condiciones ambientales adecuadas para mantenerlo operativo.

    Para muchas empresas, este modelo sigue siendo atractivo porque permite conservar el control completo sobre el hardware. La compañía decide qué servidor comprar, qué discos instalar, qué sistema operativo utilizar y cuándo hacer cambios.

    Ese control, sin embargo, también implica responsabilidad.

    Cuando un disco falla, cuando el servidor llega al final de su vida útil o cuando una fuente de poder deja de funcionar, el problema sigue siendo de la empresa. El datacenter puede ofrecer asistencia o manos remotas, pero la propiedad y la renovación del equipo continúan estando del lado del cliente.

    Por eso el costo real del housing no es únicamente la mensualidad del rack o de la unidad contratada. También hay que considerar la compra inicial del servidor, repuestos, garantías, soporte especializado, tiempo del personal técnico y renovación de hardware.

    El modelo funciona, pero funciona mejor cuando la empresa realmente quiere —y puede— seguir operando la capa física.

    El servidor dedicado reduce una parte del problema

    El servidor dedicado cambia ligeramente la ecuación. En este caso, el hardware pertenece al proveedor y el cliente alquila su uso. La ventaja es evidente: la empresa ya no necesita comprar un servidor físicamente. Si el hardware falla, normalmente el proveedor es responsable de reemplazarlo.

    Sin embargo, desde el punto de vista arquitectónico, continúa existiendo una relación bastante directa entre la aplicación y una máquina física. Esto puede ser perfectamente válido para determinadas cargas. Un servidor dedicado puede ofrecer excelente rendimiento, costos predecibles y una arquitectura sencilla.

    El problema aparece cuando la infraestructura comienza a crecer.

    Si una aplicación necesita más memoria, más CPU o mayor capacidad de almacenamiento, el crecimiento muchas veces implica cambiar de servidor o agregar nuevas máquinas. Y cuando aparecen requisitos de alta disponibilidad, replicación o recuperación ante desastres, la arquitectura empieza a hacerse más compleja.

    La nube privada cambia la conversación

    La diferencia fundamental de una nube privada no es que el servidor esté “en Internet”. Esa descripción se queda corta. El cambio real está en que la empresa deja de consumir una máquina física específica y comienza a consumir recursos virtualizados: procesamiento, memoria, almacenamiento y red.

    Debajo puede existir uno o varios servidores físicos, pero las cargas dejan de depender necesariamente de una única caja. Eso permite que una máquina virtual pueda crecer, moverse, replicarse o recuperarse con mucha mayor flexibilidad que un servidor físico tradicional.

    Para el gerente de TI, esto tiene una consecuencia importante: la infraestructura deja de estar tan atada al ciclo de vida del hardware.

    Ya no importa tanto qué modelo exacto de servidor soporta una aplicación. Lo relevante es que existan los recursos necesarios, una arquitectura adecuada de almacenamiento, copias de seguridad y una estrategia clara de recuperación.

    En Latinoamérica ya existen proveedores que trabajan precisamente bajo este enfoque. Nettix, por ejemplo, ofrece servicios de nube privada en Perú y México orientados a empresas que quieren mantener control sobre sus sistemas sin asumir directamente la compra, renovación y operación del hardware físico.

    Ese tipo de propuesta no elimina la necesidad de administrar bien la infraestructura. Lo que hace es trasladar una parte importante de la responsabilidad física hacia el proveedor.

    El precio mensual no cuenta toda la historia

    Comparar estas tres alternativas únicamente por precio suele conducir a conclusiones equivocadas.

    Un servidor comprado por la empresa puede parecer más económico porque, una vez adquirido, “ya está pagado”. Pero ese cálculo rara vez incorpora todo el ciclo de vida del equipo.

    Un servidor empresarial puede permanecer operativo cuatro, cinco o incluso más años. Durante ese periodo necesita energía, espacio en datacenter, mantenimiento, monitoreo, discos de reemplazo, copias de seguridad y personal capaz de administrarlo.

    También existe un costo menos visible: el riesgo.

    Cuando una infraestructura depende de un único equipo físico, una falla puede convertirse rápidamente en una emergencia operativa. La nube privada intenta transformar parte de esos costos variables e incidentales en un servicio más predecible.

    No significa necesariamente que siempre sea más barata. En cargas muy estables, con hardware ya amortizado y personal interno experimentado, mantener infraestructura física puede seguir teniendo sentido.

    La diferencia está en dónde se coloca el riesgo y quién tiene que resolver los problemas cuando aparecen.

    De comprar servidores a comprar continuidad

    Esta es probablemente la parte más interesante de la transición hacia modelos de nube privada. La empresa ya no está comprando solamente CPU, memoria y almacenamiento. Está comprando capacidad operativa.

    Eso incluye la posibilidad de ampliar recursos sin esperar una renovación completa del hardware, recuperar máquinas virtuales desde backups, mantener infraestructura segmentada y, dependiendo del diseño, reducir la dependencia de una única máquina física.

    Por eso algunas empresas que inicialmente comparan una nube privada con el precio de un servidor terminan cambiando la pregunta.

    Ya no dicen: “¿Cuánto cuesta este servidor?”

    Empiezan a preguntar: “¿Cuánto me cuesta mantener este servicio disponible durante los próximos cinco años?”

    La diferencia parece pequeña, pero cambia completamente la decisión.

    La pregunta correcta no es qué tecnología es mejor

    Housing, servidores dedicados y nube privada pueden convivir incluso dentro de una misma empresa.

    Una organización podría mantener determinados sistemas en hardware físico, utilizar servidores dedicados para cargas intensivas y operar aplicaciones corporativas sobre infraestructura virtualizada. El error aparece cuando una arquitectura continúa utilizándose simplemente porque “siempre se hizo así”.

    Para un gerente de TI, la evaluación debería considerar algunas preguntas básicas: ¿la empresa quiere seguir comprando servidores cada ciertos años?, ¿tiene personal disponible para resolver fallas de hardware?, ¿necesita aumentar recursos rápidamente?, ¿qué sucede si un servidor deja de funcionar hoy?, ¿cuánto tiempo tardaría en recuperar los servicios?

    Cuando las respuestas empiezan a señalar que el problema ya no es la capacidad del servidor sino todo lo que hay alrededor de él, una nube privada empieza a tener mucho más sentido.

    De poseer infraestructura a consumir capacidad

    La evolución de la infraestructura empresarial está llevando a muchas organizaciones a replantear una idea que durante décadas parecía obvia: que para controlar un sistema era necesario ser propietario del servidor que lo ejecutaba.

    Hoy el control puede existir en otra capa. Una empresa puede controlar sus máquinas virtuales, sus redes, sus sistemas operativos y sus datos sin necesariamente tener que comprar los discos, fuentes de poder o servidores que existen debajo.

    Ese cambio convierte la infraestructura en algo más cercano a un servicio que a un activo físico. Para algunas empresas será la evolución natural. Para otras, el housing o el servidor dedicado seguirán siendo opciones perfectamente razonables.

    Lo importante es que la decisión se tome considerando el costo completo, el riesgo operativo y las necesidades reales del negocio.

    Y cuando una organización decide dar ese paso, proveedores regionales como Nettix Perú y Nettix México muestran que la nube privada ya no es una opción reservada para grandes hyperscalers o corporaciones globales. También puede plantearse como una infraestructura cercana, administrada y diseñada alrededor de necesidades empresariales concretas.

  • VPN propia vs VPN administrada: costos, operación y responsabilidades

    VPN propia vs VPN administrada: costos, operación y responsabilidades

    Cuando una empresa decide implementar una VPN, la primera pregunta suele ser técnica. Qué software utilizar, qué servidor contratar o qué firewall comprar. Pero existe otra pregunta que, a largo plazo, puede ser bastante más importante: ¿quién va a operar esta infraestructura dentro de uno, dos o tres años?

    Una VPN puede empezar como una solución sencilla para cinco usuarios y terminar conectando oficinas, proveedores, clientes y sistemas críticos.

    La decisión entre administrar la VPN internamente o contratar un servicio administrado debería considerar algo más que el precio inicial.

    La VPN propia ofrece control, pero también responsabilidad

    Operar una VPN internamente puede ser perfectamente razonable cuando la empresa cuenta con un equipo de TI preparado para hacerlo. La organización mantiene control directo sobre la infraestructura, usuarios, configuraciones y cambios.

    El problema aparece cuando esa responsabilidad se suma a muchas otras.

    El mismo equipo que atiende computadoras, correo, servidores, usuarios y aplicaciones también termina administrando certificados, actualizaciones, rutas, túneles e incidencias de conectividad.

    Lo que parecía una tarea pequeña puede convertirse en otra pieza crítica dentro de la operación.

    El costo real no es solo la infraestructura

    Comparar una VPN propia con una administrada únicamente por el precio del servidor puede llevar a conclusiones equivocadas. También hay que considerar tiempo de administración, disponibilidad del personal, documentación, mantenimiento, monitoreo y atención de incidentes.

    Existe además un costo menos visible: el conocimiento.

    Si una sola persona entiende cómo funciona la VPN, la empresa depende de ella. Cuando esa persona no está disponible, cualquier problema puede convertirse en una urgencia.

    Una VPN administrada cambia quién opera la plataforma

    En un servicio administrado, la empresa sigue decidiendo quién debe acceder y a qué recursos.

    La diferencia es que la operación técnica de la plataforma queda en manos de un proveedor especializado.

    Eso puede incluir mantenimiento, soporte, cambios, monitoreo y administración de la infraestructura según el alcance contratado.

    Para el negocio, esto permite transformar una responsabilidad técnica interna en un servicio.

    Tercerizar no significa perder control

    Delegar la operación no debería significar perder visibilidad.

    La empresa debería conocer qué redes están conectadas, qué usuarios tienen acceso, cómo se solicitan cambios y cuáles son las responsabilidades de cada parte. Una buena relación con un proveedor administrado debería mejorar la gobernanza, no reducirla.

    El objetivo es separar la responsabilidad operativa del control empresarial.

    Cuándo tiene sentido mantenerla internamente

    Si una empresa tiene un equipo de redes dedicado, experiencia suficiente y una infraestructura relevante, operar internamente puede ser la mejor opción.

    No todas las organizaciones necesitan tercerizar. La decisión depende de la capacidad operativa y del papel que la VPN juega dentro del negocio.

    Cuándo empieza a tener sentido una VPN administrada

    Hay señales bastante claras. La cantidad de usuarios crece. Aparecen nuevas sedes. Existen varias conexiones Site-to-Site. Clientes solicitan integraciones específicas. La plataforma empieza a ser necesaria para tareas críticas y cualquier caída afecta la operación.

    En ese momento, la VPN deja de ser una configuración y empieza a comportarse como un servicio empresarial.

    La pregunta final no es técnica

    La mejor decisión no depende únicamente de qué tecnología puede instalar la empresa.

    Depende de dónde quiere dedicar su tiempo y conocimiento.

    Si operar redes y VPN forma parte de la capacidad estratégica del equipo, puede mantenerse internamente. Si es simplemente una necesidad para que el negocio funcione, externalizar la operación puede resultar más eficiente.

    Nettix ofrece servicios de VPN administrada para empresas, incluyendo acceso remoto, Site-to-Site e integraciones con clientes y proveedores.

  • ¿Tu cliente exige una conexión IPSec? Qué debes entender antes de implementarla

    ¿Tu cliente exige una conexión IPSec? Qué debes entender antes de implementarla

    Una empresa puede trabajar durante años con un cliente sin necesidad de tocar su infraestructura de red. Hasta que un día llega un correo del área de tecnología solicitando una conexión IPSec.

    A partir de ese momento aparecen términos como IP pública, subredes privadas, gateways, cifrado, políticas de seguridad y formularios técnicos que probablemente no forman parte de la operación cotidiana de la empresa.

    Para un proveedor, el problema no es solo “configurar una VPN”. La verdadera pregunta es cómo integrar esa exigencia con su infraestructura actual sin complicar innecesariamente la operación.

    El requerimiento del cliente responde a su propia arquitectura

    Cuando una organización grande exige IPSec, normalmente no lo hace para complicar la vida del proveedor. Forma parte de sus políticas de acceso, segmentación y seguridad.

    Desde su perspectiva, la conexión debe integrarse dentro de una arquitectura controlada.

    Para el proveedor, esto significa adaptarse a requisitos que pueden incluir parámetros específicos de cifrado, rangos permitidos, IP públicas y reglas de comunicación.

    El primer paso debería ser entender exactamente qué necesita el cliente y qué sistemas deben comunicarse.

    No necesitas conectar toda tu empresa

    Un error habitual es pensar que una conexión Site-to-Site implica unir por completo dos organizaciones. No es así.

    Una VPN bien diseñada puede permitir únicamente el tráfico necesario.

    Por ejemplo, un proveedor puede necesitar acceder a una sola aplicación dentro de la red del cliente. No existe razón para que eso implique acceso al resto de su infraestructura.

    La conexión debe construirse alrededor del flujo necesario y no alrededor de una apertura general de redes.

    Tus usuarios no necesariamente tienen que administrar IPSec

    Este punto es especialmente relevante. Si el cliente exige IPSec, no significa necesariamente que cada colaborador tenga que configurar una conexión IPSec en su computadora.

    La empresa puede disponer de una infraestructura central que establezca el túnel con el cliente. Los usuarios se conectan primero a la red empresarial y desde allí alcanzan los recursos autorizados. Conceptualmente:

    Usuario → VPN empresarial → IPSec → red del cliente

    Esto puede simplificar considerablemente la experiencia de los usuarios y centralizar el control.

    Hay que revisar direccionamiento y rutas antes de empezar

    Uno de los aspectos más importantes en una integración entre empresas es el direccionamiento IP. Si ambas organizaciones utilizan rangos similares, pueden aparecer conflictos que impidan enrutar correctamente el tráfico.

    También es necesario definir qué redes serán anunciadas, qué tráfico viajará por el túnel y cómo se comportará el resto de las conexiones de la empresa.

    Estas decisiones deberían revisarse antes de configurar el túnel y no después de que aparezcan problemas.

    También importa quién administrará la conexión

    Una VPN con un cliente corporativo no termina cuando se completa la configuración inicial. El cliente puede cambiar parámetros, añadir redes o solicitar modificaciones. También pueden existir incidentes que requieran coordinación entre ambos equipos.

    Por eso conviene definir desde el inicio quién mantiene la conexión, quién responde ante fallos y cómo se gestionan los cambios.

    Cuando una empresa tiene múltiples clientes, esta disciplina se vuelve todavía más importante.

    Una integración B2B debe ser tratada como infraestructura

    Para una pyme, trabajar con clientes grandes puede implicar asumir requisitos tecnológicos que antes no existían. La mejor forma de abordarlos es tratarlos como una pieza de infraestructura y no como una configuración aislada.

    La conexión debe estar documentada, tener responsables definidos y poder mantenerse en el tiempo.

    Si tu empresa recibió un requerimiento IPSec y no quiere asumir internamente toda la operación de la integración, Nettix ofrece servicios de VPN empresarial y Site-to-Site para clientes corporativos y proveedores.

  • VPN Site-to-Site vs Client-to-Site: qué tipo de VPN necesita tu empresa

    VPN Site-to-Site vs Client-to-Site: qué tipo de VPN necesita tu empresa

    Cuando una empresa dice “necesitamos una VPN”, todavía falta responder una pregunta importante. ¿Queremos conectar una persona o queremos conectar una red completa?

    Esa diferencia explica dos de los modelos más utilizados en entornos empresariales: Client-to-Site y Site-to-Site.

    Aunque ambos utilizan VPN, resuelven problemas distintos.

    Client-to-Site: cuando el usuario necesita entrar a la empresa

    En una conexión Client-to-Site, un usuario individual se conecta desde su laptop, computadora o dispositivo hacia una red empresarial.

    Es el caso típico de un colaborador que trabaja desde casa y necesita ingresar al ERP, servidor de archivos, panel administrativo o cualquier otro recurso que no está disponible públicamente. La lógica sería:

    Usuario → VPN → red empresarial

    Este modelo permite controlar qué usuarios pueden acceder y qué recursos tienen autorizados.

    Para empresas con colaboradores remotos, consultores o personal distribuido, suele ser la alternativa más natural.

    Site-to-Site: cuando lo que se conecta son dos redes

    En una VPN Site-to-Site no se conecta una persona, sino dos redes completas. Por ejemplo:

    Sucursal → VPN → oficina principal

    o:

    Proveedor → VPN → cliente corporativo

    Una vez que el túnel está establecido, los equipos autorizados pueden comunicarse según las rutas y políticas definidas. Para los usuarios, la conexión puede ser prácticamente transparente.

    Dos problemas diferentes

    La diferencia se entiende mejor con ejemplos.

    Si un gerente necesita conectarse desde su casa al sistema administrativo de la empresa, estamos ante un escenario Client-to-Site.

    Si una oficina en otra ciudad necesita acceso permanente a un servidor ubicado en la sede principal, estamos ante Site-to-Site.

    Si una empresa debe conectarse con un cliente corporativo mediante IPSec, nuevamente hablamos de Site-to-Site.

    El tipo de VPN depende del flujo que se quiere establecer, no de una preferencia tecnológica.

    Ambos modelos pueden convivir

    Muchas organizaciones necesitan las dos cosas. Una empresa puede tener colaboradores remotos que se conectan mediante Client-to-Site y, al mismo tiempo, mantener conexiones Site-to-Site con sucursales, datacenters o clientes. La arquitectura puede verse así:

    Usuario remoto → VPN → red empresarial → Site-to-Site → otra red

    Esto permite que los usuarios utilicen una experiencia relativamente simple, mientras que la infraestructura gestiona las conexiones más complejas detrás.

    Qué debería evaluar una empresa

    Antes de escoger un modelo, conviene revisar quién necesita conectarse, qué recursos debe alcanzar y si la conexión debe estar activa de forma permanente.

    También importa la cantidad de usuarios, las redes involucradas, el tipo de aplicación y las responsabilidades de administración.

    Una mala elección no siempre significa que la tecnología falle. Muchas veces simplemente obliga a operar una arquitectura innecesariamente compleja.

    La arquitectura debe seguir al negocio

    Una VPN empresarial funciona mejor cuando responde a procesos concretos. Si la necesidad es trabajo remoto, Client-to-Site puede ser suficiente. Si hay varias oficinas, infraestructura cloud o integraciones con terceros, Site-to-Site puede ser más apropiado.

    Cuando ambos escenarios aparecen al mismo tiempo, conviene diseñar una arquitectura que pueda crecer sin depender de configuraciones aisladas.

    Nettix implementa y administra soluciones de VPN empresarial, acceso remoto y Site-to-Site para organizaciones que necesitan conectar usuarios, oficinas, clientes y proveedores.

  • OpenVPN vs IPSec: diferencias y cuándo utilizar cada uno en una empresa

    OpenVPN vs IPSec: diferencias y cuándo utilizar cada uno en una empresa

    Cuando una empresa empieza a evaluar una VPN, es común encontrarse rápidamente con dos nombres: OpenVPN e IPSec. A primera vista pueden parecer tecnologías que compiten entre sí, como si hubiera que elegir una y descartar la otra. En la práctica, la decisión es bastante más interesante.

    Ambas permiten crear conexiones seguras, pero suelen encajar mejor en escenarios distintos. Para una empresa, entender esa diferencia ayuda a evitar una discusión puramente técnica y concentrarse en lo que realmente importa: qué tipo de VPN necesita la empresa según quién debe conectarse, desde dónde y hacia qué recursos.

    El punto de partida no es la tecnología

    Antes de comparar protocolos conviene responder una pregunta sencilla: ¿queremos conectar personas o queremos conectar redes?

    Si un colaborador necesita acceder desde su laptop a un ERP, un servidor o una carpeta interna, hablamos de un escenario de acceso remoto. Si lo que necesitamos es conectar dos oficinas, una empresa con un cliente o una red local con un datacenter, el problema es distinto.

    Ese contexto cambia por completo la decisión.

    OpenVPN suele encajar bien en acceso remoto

    OpenVPN es ampliamente utilizado para conectar usuarios individuales a una red privada. Un colaborador puede iniciar la VPN desde su laptop y, una vez autenticado, acceder a los recursos que la empresa haya autorizado.

    Para una organización, este modelo resulta útil cuando existen usuarios remotos, equipos distribuidos o personal que necesita entrar a sistemas internos desde ubicaciones distintas.

    La lógica es simple:

    Usuario → VPN → red de la empresa

    Desde el punto de vista operativo, este enfoque facilita administrar accesos individuales y separar a los usuarios de la complejidad de otras conexiones que puedan existir dentro de la infraestructura.

    IPSec suele aparecer con más frecuencia entre redes

    IPSec es muy habitual en conexiones Site-to-Site, especialmente cuando se trata de integrar redes empresariales, firewalls, oficinas o infraestructura de organizaciones distintas.

    Por ejemplo:

    Empresa A → IPSec → Empresa B

    Este tipo de conexión suele permanecer activa de manera continua y permite que determinadas redes se comuniquen según las políticas definidas.

    Por eso es frecuente que un cliente corporativo solicite IPSec cuando necesita que un proveedor se conecte a sistemas internos o intercambie tráfico con su red.

    No siempre tienes que elegir uno

    Una de las ideas más útiles para empresas es que OpenVPN e IPSec pueden coexistir dentro de la misma arquitectura.

    Imaginemos una organización donde los usuarios trabajan de forma remota, pero además la empresa mantiene una conexión permanente con un cliente corporativo.

    La arquitectura podría verse así:

    Usuario remoto → OpenVPN → red empresarial → IPSec → red del cliente

    Para el usuario, la experiencia sigue siendo sencilla. Solo necesita conectarse a la VPN de su empresa. La infraestructura se encarga posteriormente de encaminar el tráfico hacia la red del cliente.

    Esto permite separar responsabilidades y evitar que cada colaborador tenga que configurar directamente la conexión exigida por terceros.

    La decisión correcta depende del escenario

    No existe una respuesta universal a la pregunta “¿OpenVPN o IPSec?”.

    Si el objetivo es proporcionar acceso remoto a usuarios individuales, OpenVPN puede resultar una alternativa natural. Si el objetivo es conectar redes completas o integrarse con otra organización, IPSec suele aparecer con más frecuencia.

    Pero cuando ambos escenarios conviven, la arquitectura puede combinar ambas tecnologías.

    La clave está en diseñar el flujo completo antes de escoger herramientas.

    Lo importante es quién administra la conectividad

    Una empresa puede implementar internamente cualquiera de estas tecnologías. Sin embargo, cuando empiezan a coexistir usuarios remotos, múltiples sedes, clientes corporativos y varias conexiones Site-to-Site, la complejidad operativa aumenta.

    En ese momento, el reto deja de ser instalar un protocolo y pasa a ser administrar la infraestructura.

    Si tu empresa necesita integrar acceso remoto con conexiones IPSec o Site-to-Site, Nettix ofrece servicios de VPN empresarial y conectividad administrada para este tipo de escenarios.